

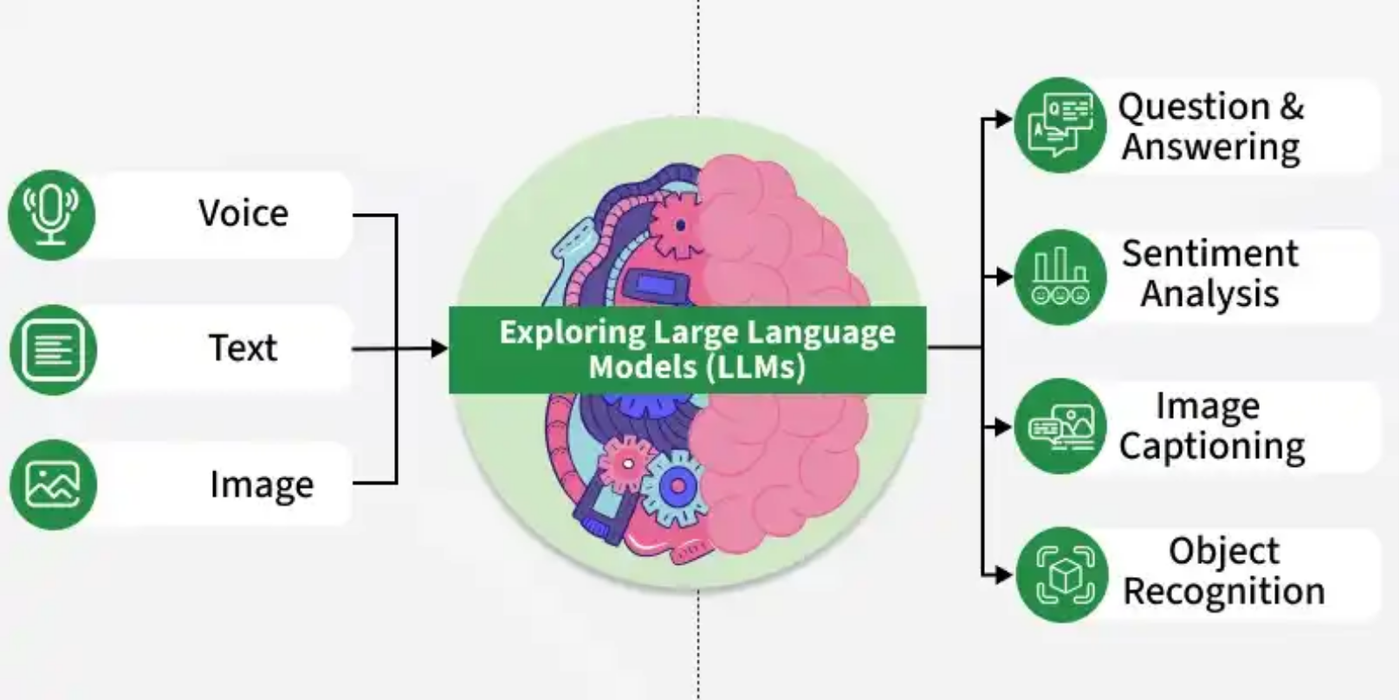
Secretul nu stă doar în modelul în sine, ci în arhitectura din jurul său, împărțită simbolic în creier și corp.
1. LLM-ul: Creierul care gândește în pași
La baza oricărui agent inteligent stă LLM-ul. Rolul lui fundamental este să genereze text, dar magia reală se întâmplă atunci când este pus să gândească pas cu pas (abordarea de tip chain-of-thought).
Modelul analizează cererea utilizatorului, își planifică pașii necesari și decide ce acțiuni trebuie să execute. Totuși, un LLM izolat este complet pasiv: el doar scrie text pe ecran și nu poate interacționa direct cu mediul extern.
2. Harness-ul (Sistemul de suport): Corpul care acționează
Pentru ca un LLM să devină un agent util, el are nevoie de un „corp” – un sistem de control cunoscut sub numele de harness. Acesta funcționează ca o punte de legătură între model și instrumentele externe.
Harness-ul îi oferă agentului trei componente vitale:
- Memoria: Istoricul conversației, fișierele atașate și instrucțiunile primite.
- Uneltele (Tools): Accesul la aplicații externe (Gmail, Calendar, Slack sau motoare de căutare), permițându-i să execute efectiv sarcini.
Cine este „partea feminină”? De ce războiul ego-urilor din Războiul Rece a dat naștere unui design spațial revoluționar

Cum menții utilajele agricole în mișcare? Soluții tehnice Flodel cu livrare rapidă în toată țara

DJI Pocket 4 devine numărul 1 în Japonia în doar 9 zile și propulsează brandul la o cotă de piață record de 72,5%
- Sub-agenții: Posibilitatea de a delega sarcini complexe în paralel către alte componente specializate.
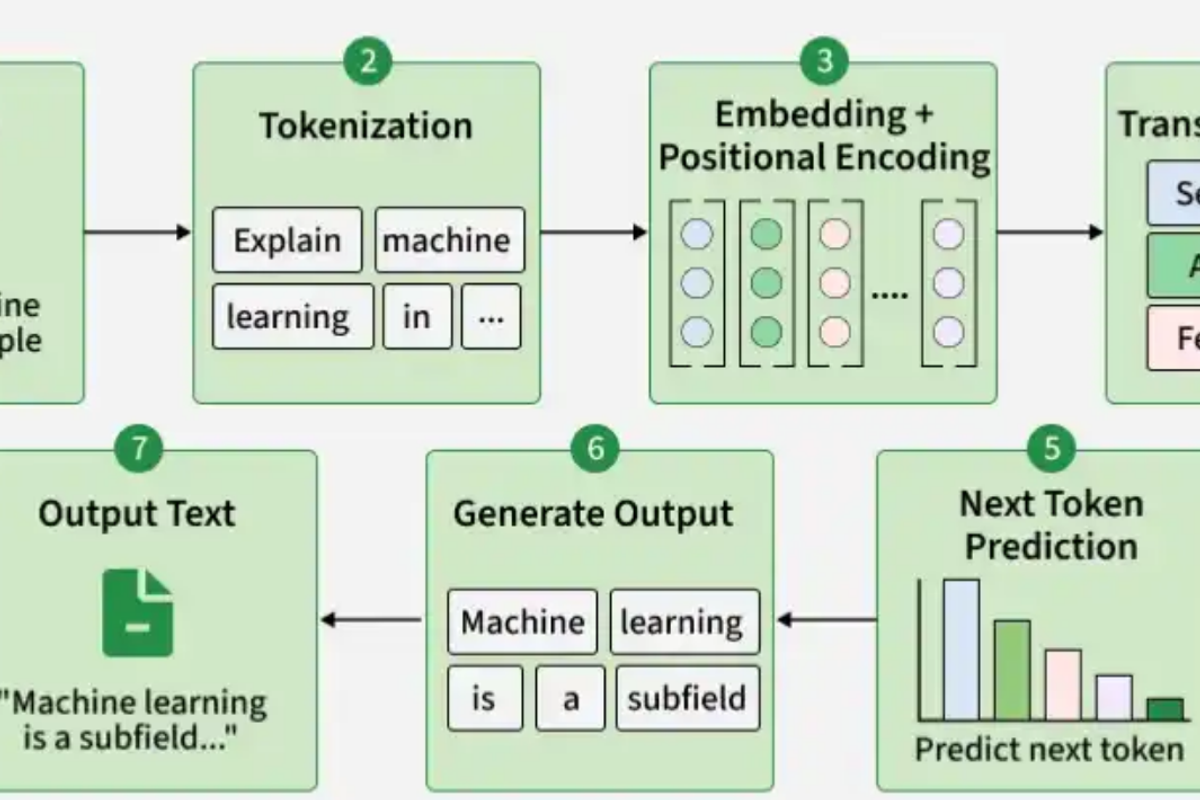
Datorită acestui „corp”, agentul nu mai doar vorbește, ci poate să ia acțiuni concrete și să facă modificări în medii digitale.
3. Fereastra de context și gestionarea memoriei de lucru
O limitare majoră a oricărui model de inteligență artificială este capacitatea sa de memorare pe termen scurt, cunoscută sub numele de fereastră de context.
Tot ceea ce se întâmplă în interacțiune – istoricul chatului, promptul tău, fișierele încărcate și răspunsurile uneltelor – se acumulează în această fereastră de context. Pe măsură ce discuția avansează, fereastra se umple treptat.
Atunci când se atinge limita maximă a memoriei de lucru, harness-ul intervine automat: detectează suprasolicitarea și execută o operațiune de compresie a contextului, condensând informațiile esențiale pentru a face loc noilor date fără a pierde firul logic al discuției.
Ce urmează?
Avem acum două piese importante: matematica din spatele modului în care un model înțelege cuvintele (embedding-urile) și arhitectura practică prin care un LLM devine un agent autonom funcțional.
 Curierulnational.ro

 Observatornews.ro
 Povesteacasei.ro

 moneybuzz.ro